プログラミング 全角 半角 変換:Python・JavaScript・C#の文字列処理比較
「プログラミング 全角 半角 変換」を実装するときは、単に見た目の幅を変えるのではなく、どの互換文字を同じ値として扱うかを先に決めます。Python、JavaScript、C#の標準APIでNFKCを使う例と、英数字だけを限定して変える考え方を並べ、半角カナ・URL・絵文字を含む入力のテスト方法まで整理します。
最初に結論
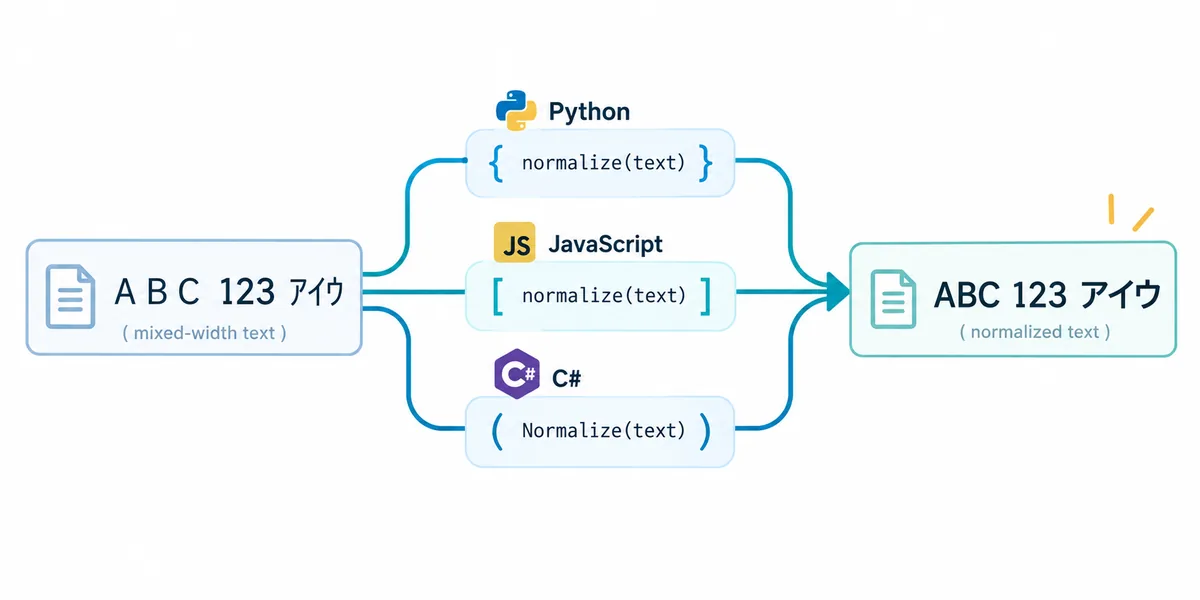
互換文字をまとめて同一視するなら3言語ともNFKC、全角英数字と全角スペースだけを変えるなら対象コードポイントを限定する実装が安全です。
- 検索キーや重複判定は、保存用の原文と正規化値を別フィールドにする。
- URL、メールアドレス、製品番号は変換対象から分け、仕様に沿って半角を保持する。
- 半角カタカナ、丸数字、単位記号、絵文字を含むテストを用意し、変換後の差分を確認する。
1. 全角半角変換を正規化として設計する
全角の「ABC123」と半角の「ABC123」は、人間には同じ内容に見えてもコードポイントが異なります。入力フォーム、CSV取込、検索インデックス、ログ解析で値を比較するなら、比較前に同じ形へ寄せる処理が必要です。ただし、表示用の本文まで一律に変えると、帳票の桁合わせや固有の表記を壊すことがあります。
UnicodeのNFKCは、互換性のある文字を標準的な表現へ寄せる正規化です。全角英数字をASCIIへ寄せる用途に便利ですが、半角カタカナが全角カタカナになるなど、幅以外の差もまとめて変わります。記事内では「幅だけを変えたいケース」と「互換表現を同じ値として扱いたいケース」を分けて説明します。
| 目的 | 候補 | 先に確認すること |
|---|---|---|
| 検索・照合の揺れを減らす | NFKC | 丸数字、単位記号、半角カナも変化してよいか |
| 全角英数字だけを半角へ | 範囲限定 | U+FF01〜U+FF5EとU+3000だけを対象にするか |
| 帳票の表示幅をそろえる | 明示的な全角化 | URL・ID・メールを対象外にできるか |
| 原文を監査用に残す | 別フィールド保存 | 原文、正規化値、表示値の役割を分けるか |
2. Pythonで全角半角を変換する
Pythonでは標準ライブラリのunicodedata.normalizeを使います。第1引数にNFKCを指定し、文字列を渡すだけなので、CSVの読み込み後や検索キーを作る前の共通関数にしやすい方法です。空文字はそのまま返り、Noneを受ける場合は呼び出し側の契約を決めておきます。
import unicodedata

def normalize_width(text):
    if text is None:
        return None
    return unicodedata.normalize("NFKC", text)

print(normalize_width("ABC123 アイウ"))
# ABC123 アイウ
この例では全角英数字と全角スペースに加え、半角カタカナも変化します。検索キーなら便利でも、半角カナを保存する古い連携システムでは意図しない差になるため、入力欄ごとに適用を分けます。NFKCの結果をそのまま画面表示へ使うのではなく、原文を保持したまま比較用の列へ保存する設計も有効です。
英数字だけを対象にする場合は、文字コードの範囲を確認して1文字ずつ変換します。Pythonではordとchrを使えますが、対象外の日本語、絵文字、改行はそのまま返す条件を明示してください。処理後に文字列全体を再エンコードするだけでは、全角半角の問題は解決しません。
3. JavaScriptでフォーム値を整える
ブラウザとNode.jsでは、文字列のnormalizeメソッドに"NFKC"を渡します。入力イベントのたびに実行するとカーソル位置やユーザーの入力途中の状態を扱いにくくなるため、送信時、検索開始時、または貼り付け完了後など、値を確定するタイミングに置くのが実務的です。
function normalizeWidth(value) {
  if (value == null) return value;
  return value.normalize("NFKC");
}

const raw = "JS 123 カタカナ";
const normalized = normalizeWidth(raw);
// JS 123 カタカナ
URLやメールアドレスを同じ関数へ渡すと、検索用の値と送信先の値を混同する可能性があります。たとえばフォームの氏名欄にはNFKCを使い、URL欄は入力仕様に合わせてASCIIチェックだけを行う、といったフィールド単位のルールを持たせます。サーバー側でも同じ規則を再確認し、クライアントだけを信頼しないことが重要です。
JavaScriptのnormalizeは、フォームの見た目を全角に戻す機能ではありません。NFKCで半角ASCIIを全角表示へ戻すことはできないため、帳票用に全角化が必要なら、対象範囲を明示する別関数を用意します。変換前後の値をログに出す場合は、個人情報や認証トークンをそのまま記録しないようにします。
4. C#で.NET文字列を正規化する
C#ではSystem.String.NormalizeにNormalizationForm.FormKCを渡します。PythonやJavaScriptと同じく、互換文字を標準形へ寄せる操作であり、文字列の入力検証やHTMLエスケープを代わりに行うものではありません。
using System.Text;

static string NormalizeWidth(string? value)
{
    return value?.Normalize(NormalizationForm.FormKC);
}

var result = NormalizeWidth("C# 2026 カタカナ");
// C# 2026 カタカナstring?を許可するか、nullを例外にするかはAPIの契約として固定します。データベースの検索キーを作る場合は、既存レコードにも同じバージョンの正規化を適用しないと、登録時と検索時で結果がずれることがあります。入力値を上書きせず、正規化後を別プロパティへ保持すると再計算しやすくなります。
.NETのNFKCも幅以外の互換変換を含みます。丸数字、単位記号、半角カタカナを保持したい要件では、FormKCを使う前にサンプルを列挙し、対象コードポイントを限定する実装へ切り替えてください。C#のcharを1文字ずつ処理するとサロゲートペアを分割しやすいので、絵文字を含む値は文字列APIやルーン単位の設計を検討します。
5. 3言語の違いと限定変換
3言語の標準APIは、同じ入力を同じ正規化方針へ寄せるための入口です。関数名だけをそろえても、実行環境のUnicodeバージョンやnullの扱い、フォーム値を正規化するタイミングが違えば結果が一致しないことがあります。共有仕様書に入力例と期待値を書き、各言語のテストへ移します。
| 言語 | 標準API | 向いている場面 | 注意点 |
|---|---|---|---|
| Python | unicodedata.normalize | CSV、ETL、検索キーの前処理 | Noneの扱いと列ごとの適用範囲を決める |
| JavaScript | String.prototype.normalize | フォーム確定時、Node.jsの入力処理 | URLやIDを画面の正規化と混同しない |
| C# | String.Normalize(FormKC) | .NET API、データベース照合 | 既存データと同じ正規化規則を共有する |
全角ASCIIだけを半角へ変えたいときは、U+FF01〜U+FF5EをU+0021〜U+007Eへ移し、U+3000を半角スペースへ変える方式を各言語で実装できます。この限定方式なら半角カタカナや丸数字を残せますが、変換範囲を広げるたびに仕様とテストの更新が必要です。入力が日本語本文とシステム項目で混在するなら、ひとつの万能関数にせず、用途名を付けた関数を分けます。
normalizeForSearch、normalizeForDisplay、normalizeAsciiWidthのように目的を関数名へ含めると、呼び出し側がNFKCの副作用を意識しやすくなります。6. テストケースと運用上の注意
最低限、変換したい入力と、変換してはいけない入力を同じテスト表へ入れます。全角英数字、全角スペース、半角カタカナ、丸数字、URL、改行、絵文字、空文字、nullを並べると、NFKCと限定変換の差をレビューできます。
| 入力例 | NFKCの確認 | 限定変換の確認 |
|---|---|---|
ABC123 | ABC123 | ABC123 |
全角 空白 | 半角スペースへ寄る | U+3000だけ変えるか選べる |
アイウ | 全角カタカナになる場合がある | 対象外なら保持 |
① ㎏ | 互換表現の変化を確認 | 保持しやすい |
https://例.jp/A | URL全体を変えない | ホスト名やパスの仕様を別に検証 |
日本語😀\n | 改行・絵文字を保持 | コードポイント分割に注意 |
テストは各言語で同じ期待値を使い、CIで実行環境の差を検知します。データベースの照合順序、APIのJSONエンコード、ログの出力先も確認し、文字幅変換と文字コード変換を混同しないようにします。文字幅をそろえても、SQLインジェクション対策、HTMLエスケープ、URLエンコードは別の責務です。
実際の業務では、変換前後のサンプルを少量で比較してから一括処理へ進みます。原文を別列に残し、正規化規則のバージョンを記録しておけば、将来ルールを変えたときも再計算と監査が可能です。
用途別に選ぶ
短い文字列を手作業で確認するなら全角半角変換ツール、コードポイントやASCII値まで確認するならASCII変換ツールが便利です。Unicodeとエンコードの違いは文字コード変換の解説で整理できます。
Javaの実装をすでに運用している場合は、Java全角半角変換の記事でNormalizerとコードポイント方式を確認したうえで、このページの比較表を仕様書へ反映してください。Office文書の見た目を整える目的なら、オフィス文字変換の手順のように対象範囲とレイアウト確認を優先します。
プログラミング全角半角変換のよくある質問
Pythonで全角英数字だけを半角にするには?
NFKCでは半角カナや互換記号まで変わる可能性があるため、英数字とU+3000だけを対象にする関数を用意します。対象外のコードポイントをそのまま返し、全角ASCIIの範囲をテストで固定してください。
JavaScriptのnormalizeはブラウザで使えますか?
現行のブラウザとNode.jsで利用できます。入力途中ではなく送信や検索開始のタイミングに適用し、サーバー側でも同じ正規化方針を再確認します。
C#で全角半角を変換する標準方法は?
value.Normalize(NormalizationForm.FormKC)が基本です。FormKCを使わない限定変換が必要な場合は、対象範囲とnullの扱いを明示した別メソッドを作ります。
NFKCで半角を全角へ戻せますか?
NFKCは互換表現を標準形へ寄せる処理なので、半角ASCIIを全角表示へ戻す逆変換ではありません。帳票専用の全角化は、ASCII範囲とスペースを明示的に変換します。
半角カタカナやURLを変換してもよいですか?
入力先の仕様によって異なります。半角カナを保持する連携や、文字列がそのまま機能するURL・IDはNFKCの対象から分け、項目ごとに検証してください。
まとめ
プログラミングの全角半角変換は、Pythonならunicodedata.normalize、JavaScriptならString.prototype.normalize、C#ならString.Normalizeが入口になります。互換表現を同じ値として扱うならNFKC、英数字とスペースだけを変えるなら限定変換を選び、URL・ID・半角カナ・絵文字を含む同じテスト表を3言語で共有してください。
変換処理の前に原文と正規化値の役割を分け、目的が分かる関数名と仕様書を残すと、表示用データと検索用データの取り違えを防げます。
参考情報
- Python公式ドキュメント:unicodedata.normalize(Unicode正規化)
- MDN:String.prototype.normalize(JavaScriptの正規化フォーム)
- Microsoft Learn:System.String.Normalize(.NETのNormalizationForm)